應用程式、電影和世界。選擇一種方式進入。點擊卡片探索 ↗
新想法。帶點東西走。
最新的 8 篇現場筆記。點擊卡片探索 ↗
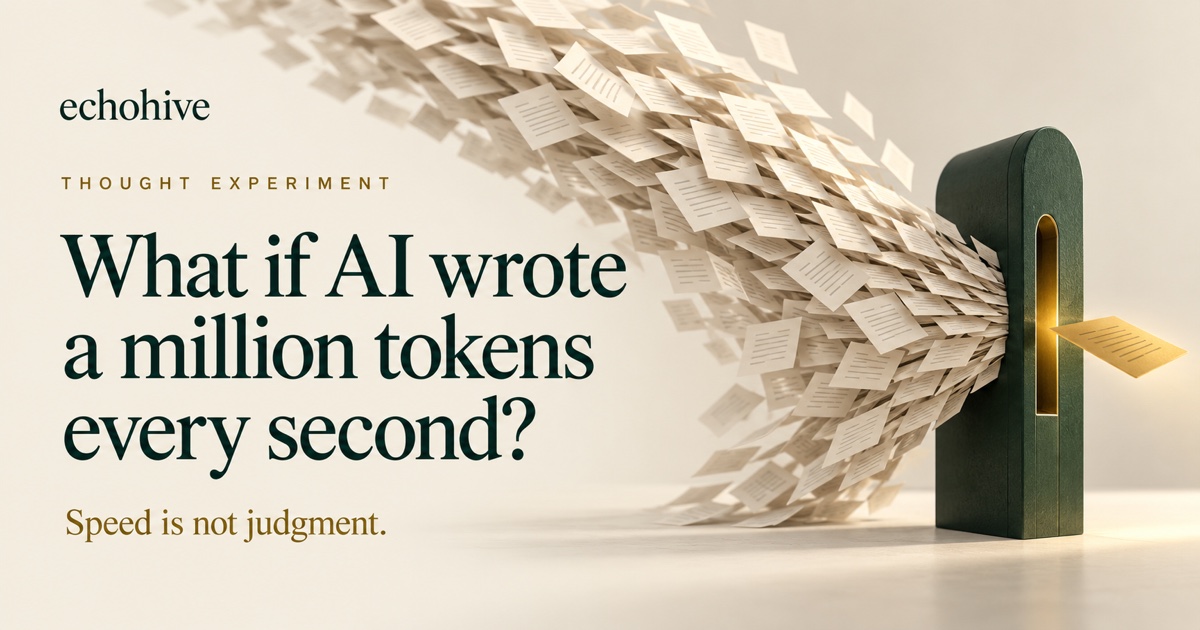
現場筆記 · 一個關於速度與判斷的思想實驗
想像一個有能力的 AI 代理,每秒能寫出一百萬個輸出 token。草稿會幾乎瞬間送達。但知道該信任哪一個,卻不會。
2026 年 10 月 2 日 · 電影 6:56 · 約 5 分鐘閱讀
觀看電影,或閱讀互動指南。相同的想法,依你的步調。
原始動畫電影,配有旁白和音樂。點擊圖片播放。這是一個思想實驗,而非對任何現有模型的測量。下方的閱讀版本增加了兩個互動計算器。
在想像中的每秒一百萬個 token 速度下,許多任務的寫作時間將縮短至幾秒鐘。圍繞著它的所有事物都保持其時鐘:決定你想要什麼、測試、在現實世界中嘗試想法、支付運算費用。當選項快速出現時,稀缺的技能是判斷它們。
一個思想實驗,而非預測。它假設了一個有能力的代理,而非通用人工智能;沒有現有模型被聲稱能以如此快的速度運行。更快的寫作不等於更好的推理。
例如,Anthropic 的 Claude Opus 5.5 概述,列出了一個 100 萬 token 的上下文窗口,每次請求的輸出上限較小,並且有「中等」的比較延遲。記憶體大小不等於寫作速度,也不意味著一百萬 token 的回覆適合單一請求。
工程技術有其極限。服務透過批次處理多個請求來達到龐大的總量,正如 2023 年的 vLLM 論文所述,而投機解碼可以在一次傳遞中接受幾個草稿 token。兩者都無法消除第二步需要第一步結果的真正鏈結。
Token 是文本的一塊,通常是單詞的一部分,因此 token 數量不等於單詞數量。
選擇一個工作負載,然後將想像中的速度從每秒 100 個 token 滑動到 1,000,000 個 token。
在每秒 1,000,000 個 token 的速度下,1,000 個故事結局(1,000,000 個輸出 token)大約需要 1 秒寫完。
想像的比較,而非任何模型的測量。時間僅計算產生的輸出:不包含閱讀、排名、工具呼叫、權限、測試、部署、人員或實驗。預算是一個寫作額度,而非完成品。
平行串流也可以加速這些獨立的任務。但每個草稿仍然需要在自己的串流上花費時間:總吞吐量與完成時間不匹配。一個快速的代理在每個步驟都等待上一個步驟時最為重要。
Get Amplified 是 echohive 的生活現場指南,用於建構 AI 和指導代理、使用更好的工具研究市場,以及磨練注意力。它將類似的想法與實際工作流程以及檢查有效方法的習慣連結起來。
每個預算僅計算寫出的輸出。沒有一個是完成品、經過驗證的發現或實際結果。
1,000 × 1,000 = 1,000,000 token · 1 秒寫作
要求一個故事的結局,並獲得一千個:充滿希望的、黑暗的、奇怪的。沒有人會讀一千個,所以有用的版本會為你映射它們以供探索,然後融合你喜歡的兩個。
仍然稀缺:品味。只有你知道哪個結局是你的。
40 × 20,000 = 800,000 token · 0.8 秒寫作
描述一個用於共享工具的借貸應用程式,在你完成句子之前,就有四十個草稿存在。螢幕可以適應,從借梯子到報名維修日。測試仍在自行運行,如果沒有一個檢查七天到期日,所有四十個都可能通過,同時借出梯子七十天。
仍然稀缺:清晰的規格,以及「工作」意義的測試。
10,000 × 300 = 3,000,000 token · 3 秒寫作
尋找更好的催化劑?一個代理可以提出並批評一萬個候選者。然後一切都在實驗室等待:反應可能運行數小時,培養皿運行數天,現場試驗運行一個季節。一個模型的想法也可能共享一個盲點。
仍然稀缺:物理證據,以及選擇哪個實驗值得實驗室時間。
10,000 × 1,000 = 10,000,000 token · 10 秒寫作
在與房東談論租約之前,一個代理可以將對話模擬一萬種方式:固執的房東、慷慨的房東、疲憊的你。像飛行模擬器一樣使用它,用於練習和發現盲點。一萬次錯誤的演練,是自信的錯誤,而非預言。
仍然稀缺:對真實人物的忠實度,以及你自己的練習。
以四十個應用程式草稿為例:800,000 個輸出 token。比較每秒 100 個 token 的說明性數字與想像中的一百萬個,然後加上一個寫作速度無法觸及的固定檢查,例如測試運行。
經過 60 秒的檢查,批次在 100 token/秒 的速度下需要 2 小時 14 分 20 秒,而在 1,000,000 token/秒 的速度下需要 60.8 秒。這比端到端快 132.57 倍,而檢查佔了較快總時間的 98.7%。
玩具模型:總時間 = 輸出 token ÷ 速度 + 一次固定檢查,為整個批次(非每個草稿)計算一次,在寫作結束後進行。它不模擬平行測試、成本、能源或草稿品質。
在一次一分鐘的檢查後,工作從 8,060 秒減少到 60.8 秒:大約快了 132.57 倍,而不是 10,000 倍。在零檢查時, returns 達到 10,000 倍;在一天檢查時,收益幾乎消失。任何你沒有加速的部分,都將成為剩餘時間的大部分,這是 Amdahl 定律的邏輯。實際請求有更多這樣的步驟:OpenAI 的延遲指南指出,非常大的提示、工具呼叫和網路往返會增加額外的延遲。
以上每個實驗都以相同的方式結束。仍然稀缺的是判斷力,它戴著不同的帽子:
快速不等於便宜:每個 token 的運行都需要有人付費的硬體。更多的選項也不能保證一個好的選項。來自單一模型和單一套假設的草稿可能相關,或者全部錯誤。數量衡量輸出,而非理解。
無需想像的撥盤。下次你將工作交給 AI 代理時:
如果你的慢速步驟是決定衡量什麼或做哪些賭注,那更多是策略而非工具。私人諮詢有助於釐清更大的系統以及你的下一步行動在哪裡有意義 ↗
更快的寫作拓寬了你可以嘗試的範圍。它無法告訴你哪個選項是正確的,你的測試是否正確,或者世界會怎麼做。將速度花在選項上。將判斷力花在選擇上。
這篇現場筆記改編自 echohive 的電影《每秒一百萬個 token》;它是一個編輯過的伴侶,而非逐字稿。速度是想像的,沒有來源測量、聲稱或預測它。它們僅支持容量、閱讀、服務和寫作之間的區別。
01 節中連結的 2023 年 vLLM 論文也是歷史基礎。所有工作負載、速度、預算和瓶頸模型都是說明性的算術,而非基準測試、預測或產品規格。資料來源檢查於 2026 年 10 月 2 日。
保持好奇心。加強實踐。
按照自己的步調學習,週日與他人一起思考,或獲得關於你自身方向的幫助。Architect 會員資格包括完整的 Get Amplified 系列以及 1000x Lab:主要是現場討論和回放,而非編碼課程。私人諮詢是獨立的,不包含在內。
從有趣的點子轉變為可重複的實踐:AI 工作流程、研究方法、市場和注意力。
將你的問題帶到週日對話中。透過現場討論和回放,探索不斷變化的想法及其影響。
從工具中抽離。釐清更大的系統、什麼值得你關注,以及你的下一步行動在哪裡具有槓桿作用。
準備好將其變成實踐了嗎?在 Patreon 上比較 Get Amplified 和 1000x Lab 選項,那裡有詳細的當前等級說明。
Echo 開發的一個不斷演進的 AI 實驗室:影片課程、現場週日實驗室以及跨 AI、市場和心智的開放實驗。
市場材料是教育性分析,而非個人化投資建議,且不保證任何回報。The Latent Lab of the Mind 是與 AI 研究並行的個人探索,而非治療或臨床護理。會員資格和諮詢透過 Patreon 計費和取消;Patreon 上的當前等級說明控制確切的存取權限和條款。