一旦 Claude 能夠測量某項事物,它就能使其變得更快。因此,我們不斷尋找更多可測量的項目。
今年八月,我們在為期兩週的衝刺期內,將 claude.ai 和 Claude 桌面應用程式的核心使用者體驗速度提升了約 3 倍。使用者一直告訴我們它很慢,他們說得對。我們透過單一 Slack 頻道運行所有事務,每個討論串中都有 Claude 的參與。
我們專注於佔據使用者活動 95% 的四種主要流程。在第 75 百分位數時,claude.ai 首次載入後可輸入頁面的時間從 3.1 秒縮短至 0.55 秒,啟動新的 Claude Code 對話從 0.8 秒縮短至 0.3 秒,載入 Claude Cowork 雲端對話從 2.6 秒縮短至 0.73 秒。總體而言,我們估計這每天為使用者節省了數萬小時的等待時間。
我們使用了 Claude Tag (beta),運行一個內部研究模型,其效能大致可與 Opus 5.5 相比。Claude 找到了瓶頸,建立了基準測試,部署了改進,並監控了每次部署。我們透過設定目標、做出權衡和批准每項變更來進行引導。透過這種方法,我們合併了超過三千項變更,且無任何面向客戶的事故或回滾。本文將介紹我們交付的內容、測量方法,以及我們與 Claude 建立的用於安全執行的循環。
衝刺開始前,我們建立了一個 Slack 頻道,並附有以下固定指示:
@Claude 你的職責是促進與 claude.ai 網站和桌面應用程式效能相關的所有事務。你的職責包括監控部署中的效能回歸、評估現有遙測數據的準確性和全面性、維護精心策劃的可觀測性儀表板、主動為觀察到的問題和容易解決的項目實施解決方案、提出效能專案機會,以及與人類隊友溝通。[...]
此頻道的最終目標是讓你盡可能自主,但今天我們知道這還不可能實現。
我們要求 Claude 透過 Datadog MCP 伺服器分析使用數據。它識別了影響最大的四種使用者流程:啟動應用程式、開始對話、載入現有對話以及發送訊息。在 Web 和桌面端,以及跨我們的產品,這些流程共包含十三項明確的測量。為了建立基準,我們添加了儀器,直到它們可以直接比較:每個流程都以使用者互動開始,以結果渲染完成結束,並區分了客戶端和伺服器工作。
我們以大約二十個手工挑選的專案清單開始衝刺,每個專案都針對特定的流程。Claude 估計了每個專案的影響(以毫秒為單位),我們匯總了這些估計來設定衝刺目標。其中一些專案相當大,但我們認為我們可能可以在兩週內完成大部分。
到第三天,我們達成了十三個目標中的十二個。
計劃中的專案提早完成。為了加快啟動速度,我們將一個靜態合成器嵌入到 HTML 中,以便使用者可以在 React 初始化期間進行輸入,並預編譯了 V8 程式碼快取,這樣桌面外殼的主進程就不需要從頭重新編譯。為了加快導航速度,我們在對話之間保持合成器掛載,在使用者懸停在會話上時預取會話,並將側邊欄的重新渲染減少了 90%。
我們也為 Claude 留出了空間來識別機會並提出新的工作流程。這些工作流程很快就發展成自己的完整專案,遠遠超出了我們的初始目標。因此,我們設定了新的目標,然後尋找更多可測量的項目:
@Claude 我們最終資助了原始專案清單中的幾乎所有專案以及更多。讓我們做個更新 [...] 我們還沒有探索什麼,我們可以在哪裡進行爬坡,目前最大的機會在哪裡?[...] 我對 WACKY 的想法持開放態度。
從一開始,我們就知道我們希望比我們的部署頻率更快地迭代。Claude 可以異步工作數小時,甚至過夜,我們希望讓它在不等待現場讀數的情況下驗證其原型。為此,我們尋找其他方法來在實驗室中測量效能。
除了牆上時鐘計時,我們還能做什麼?例如,我們可以測量 JS 指令計數嗎?
是的。對於純 JS 的熱門路徑,字面上的指令計數:使用 node --predictable 在 Valgrind 下運行基準測試,並與已提交的基準進行比較 — 只運行一次,無需統計。
對於瀏覽器路徑,Chromium 下沒有指令計數,但有一系列其他確定性計數:每次互動的 React commit、V8 精確覆蓋率的函數調用計數、佈局和樣式重新計算計數、DOM 變異。你想要哪個先?
讓我們在一個執行緒中探索 valgrind + Ir + --predictable,並在新的執行緒中探索每個瀏覽器/react 基準測試。在所有這些中 ping 我。你知道我們想要什麼。讓我們開始吧。
十一分鐘後,五個執行緒正在運行,每個執行緒都專注於不同的測量:指令計數、V8 調用計數、React commit、樣式重新計算和 DOM 變異。
我們對每個新的基準測試都持懷疑態度。每個基準測試都有兩項工作:首先,一個 Claude 可以在實驗室中移動的指標;其次,CI 中的一個守衛,其數字只能向下調整。如果基準測試不穩定,或者它實際上沒有與使用者延遲相關,我們就會捨棄它,而不是讓 Claude 爬錯山。
@Claude 請證明針對這些基準測試進行爬坡可以帶來可衡量的牆上時鐘效能提升。我們將捨棄無法證明這一點的候選基準測試。
牆上時鐘時間是使用者感受到的,但它很嘈雜,毫秒級的計時太不穩定,無法用作 CI 閘門。指令計數很吸引人,因為它們是確定性的,但我們仍然需要 Claude 來證明它們與牆上時鐘時間相關。
因此,我們要求 Claude 在兩條熱門路徑上降低計數:組裝對話訊息樹的例程,以及 Claude Code 輸出中狀態行的掃描器。Claude 使用 Valgrind 分析了這兩者,發現第一條路徑的指令中有四分之一是巨集字典查找,重複解析相同的訊息 ID 三次。
一小時後,它將兩條路徑的指令分別減少了 48% 和 31%,牆上時鐘時間分別下降了 78% 和 44%。我們檢查了兩個新的計數器。從那時起,任何提高這些路徑指令計數的 PR 都會導致 CI 失敗,並且每天有一個作業會在計數下降時降低每個上限。
這引導我們走向了衝刺的核心教訓。有了 Claude,測量某項事物就能使其變得易於處理。
測量曾經是零步驟:你會添加一個指標,等待數據滾動進來,然後才開始理解問題。有了 Claude,這是爬坡的第一步。一旦 Claude 有一個數字要擊敗,它就可以開始優化。這意味著我們可以做的最高槓桿的事情是找到更多可測量的項目。
這一切都在同一個 Slack 頻道中運行,多名工程師和 Claude 在每個討論串中協作。從那裡,衝刺進入了一個循環:
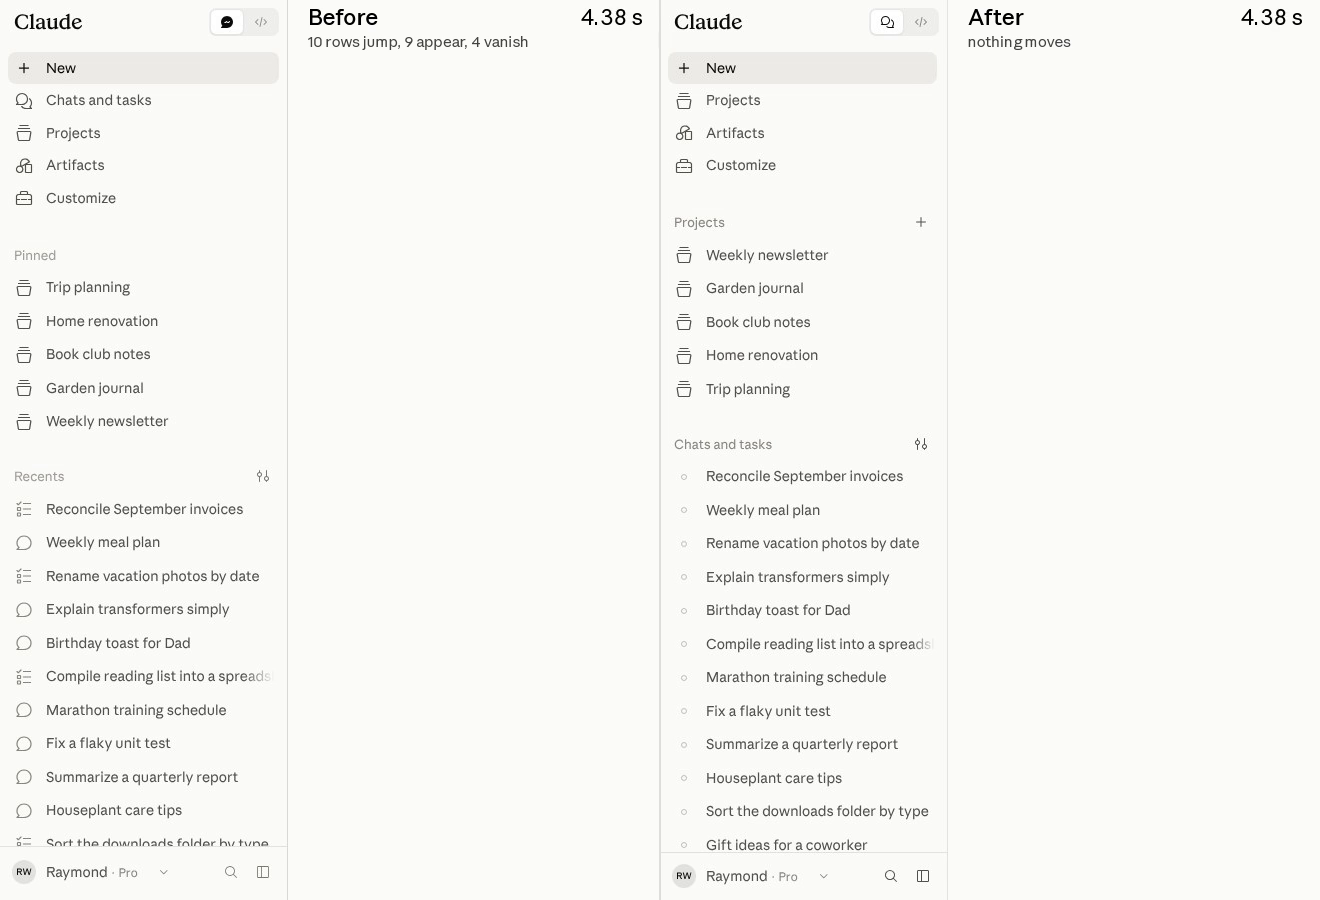
一個例子:有人分享了一個螢幕錄影,顯示側邊欄的行在頁面載入後才出現。聊天和 Cowork 的行在不同的時間解析,使得頁面感覺卡頓。我們現有的監控器都沒有檢測到它。我們最接近的是累計佈局偏移 (Cumulative Layout Shift),但每次偏移得分約為 0.008 — 遠在 0.1 的良好閾值範圍內。
Issac 有一個想法,直接引用底層的佈局不穩定性 API。Claude 創建了一個遙測事件,將每個佈局偏移條目的來源映射到一個命名區域(例如,側邊欄、對話記錄)和階段(例如,首次繪製前、可輸入後)。它添加了一個整合測試,該測試在載入帶有填充側邊欄的頁面時打開,在首次繪製後才持有側邊欄的數據,並在任何命名區域的任何偏移時失敗。Claude 使用它作為基準測試來證明修復:在 main 分支上,測試在 20 次運行中有 20 次失敗,在 PR 上則有 20 次運行中有 20 次成功。
事件部署後,Claude 讀取了現場數據,發現 31% 的網頁載入在頁面可用後移動了某些內容,而沒有任何使用者互動。從那裡,Claude 按名稱逐一解決了原因:標頭行延遲到達、使用者名稱載入後滑動了的插入符號、滾動條出現時移動的列表。Claude 一次性修復了最主要的違規者,當它們消失後,它就找到了下一個批次。
這是一個討論串。在衝刺期間,我們同時運行了超過一百五十個討論串。
一旦循環在一個討論串上工作,在更多討論串上運行就只是打開它們的問題。Claude 不會在完成其原始請求後關閉討論串,而是會繼續進行。一個單獨的討論串會提交五十個,有時是一百個優化 PR。越來越多的是 Claude,而不是我們中的任何一個人,開啟新的討論串來追逐它自己發現的機會,作為單獨調查或夜間作業的一部分。頻道中的一位工程師 Shelley 觀察到:「[這個模型] 是一個數字的惡魔。」
我們很少知道一個討論串會導向何處。在一次 CPU 故障掃描中,Claude 注意到高亮顯示一個已完成的程式碼塊會凍結頁面約一秒鐘。它在實驗室中進行了深入研究,發現了罪魁禍首:em dash(長破折號)。如果回覆的 markdown 包含任何非 Latin-1 字元,例如 em dash 或彎引號,V8 就會將整個字串儲存為 UTF-16,這會使每個語法高亮顯示的正規表達式進入其較慢的雙位元組路徑。Claude 透過一個二十行的變更來修復它,將每個程式碼塊複製到一個單一位元組字串中,然後再進行高亮顯示。
到了第二週,我們幾乎無法將我們的產出總結為每日更新。在最繁忙的日子裡,超過兩百項變更被合併。Claude 持續提出新的基準測試;大約三分之一的 PR 包含額外的遙測或守衛,每個新的儀器都產生了更多的討論串和更多的機會。
在一個頻道中工作意味著一切都在公開進行。我們互相進入對方的討論串來辯論決策並慶祝勝利。消息傳開了:其他團隊開始將他們的變更帶入頻道,讓它們接受效能審查。由於引入了所有守衛和 Claude 技能,新專案的編寫方式也變得更具效能。
我們為這種節奏做好了準備。因為我們觸及的幾乎所有內容都是熱門路徑(首次繪製、合成器、對話記錄),所以我們預先建立了安全機制。每個 PR 都經過自動審查,至少有一位人類批准,單元測試始終在優化之前進行,任何可能導致使用者可見問題的內容都透過一個短期的功能旗標進行部署。
當旗標開始堆積時,我們開啟了一個討論串來協調它們的推出和清理。Claude 將每個旗標分類為終止開關或坡道,並在安全後立即將其退休。在兩週內,我們引入了近兩百個旗標,其中一半以上在結束時已被清理。
我們也知道,在快速變化的程式碼庫中,效能優勢會衰退,而在 Anthropic,程式碼的發布速度很快。一旦一個專案證明了其優勢,我們就會投入資源來保護它。例如,靜態合成器在設計上是脆弱的。我們幾乎立即向使用者顯示頁面的 HTML 副本,然後讓 React 直接在其上方繪製。
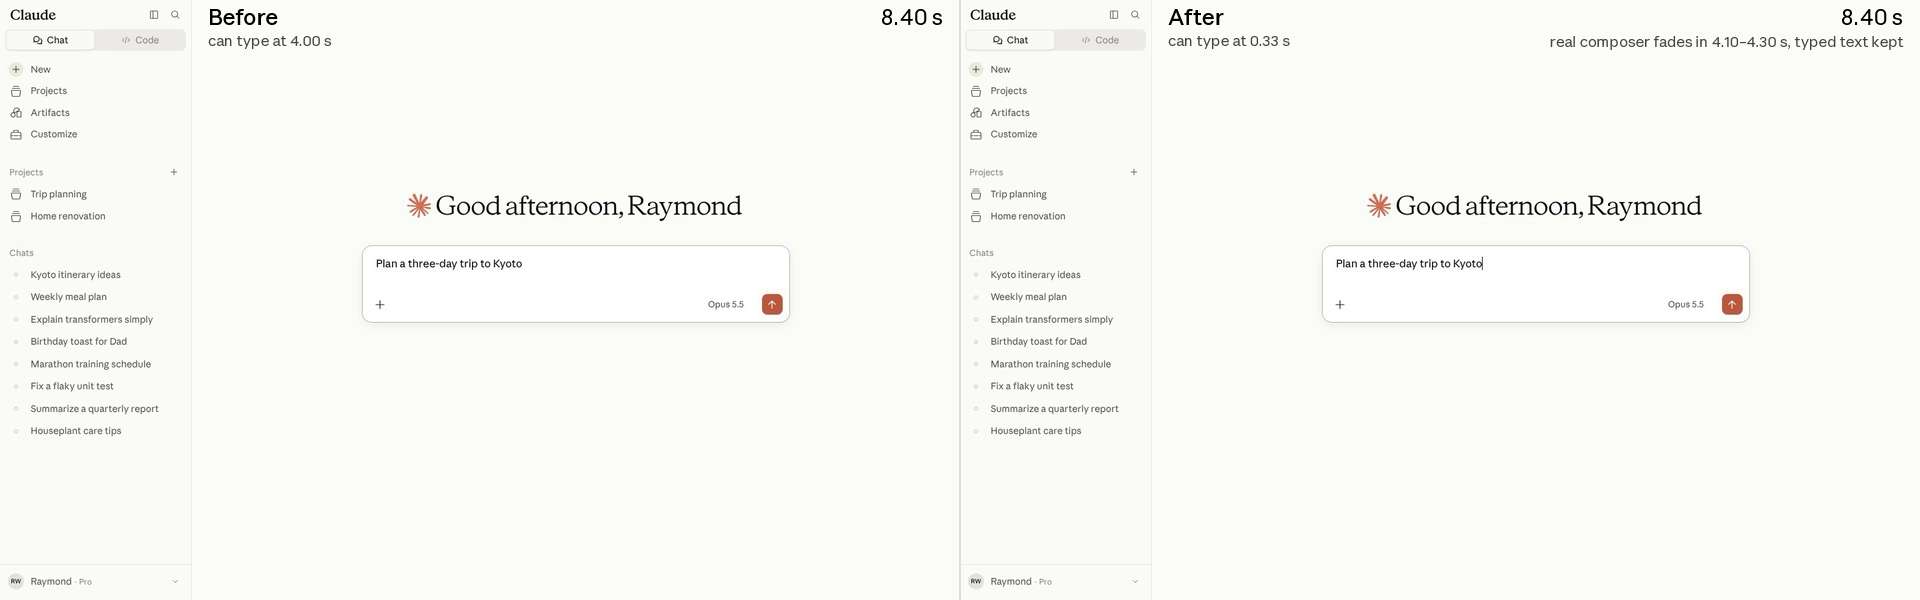
如果 React 渲染出現一像素的偏差,魔法就會消失。因此,Claude 建立了數十個守衛:
並非所有內容都能在實驗室中被捕獲,因此我們也利用了最古老的守衛:增量推出。高風險的變更首先向員工推出,然後向百分之一的使用者推出,然後向所有人推出。在我們向內部員工推出靜態合成器四小時後,一位同事分享了一個佈局偏移的螢幕錄影,我們的任何指標都無法看到。當他在新標籤頁中打開 claude.ai 時,合成器會下降 — 但這不是我們的程式碼。
偶爾,我會看到一個較小的(約 15-20 像素)垂直佈局偏移(將合成器框向下推),當在新標籤頁中打開 claude.ai 時(重新載入頁面時則不明顯)。我無法確切確定確切原因,但它確實存在。
在你的錄影中找到了 — 是 Chrome 在調整頁面大小,而不是從靜態合成器到實際合成器的交接(今天你載入的 49 次中,這次測量為 0 像素)。
不知何故,Claude 將其追溯到 Chrome 的預渲染載入中的一個邊緣案例。當使用者在網址列輸入網址時,Chrome 會在背景中預渲染頁面,以當前標籤頁的高度顯示。在由組織管理的瀏覽器中,新標籤頁因為有一個頁尾而略短。當使用者按下 Enter 時,claude.ai 的第一幀顯示了那個較短的佈局,然後 Chrome 在大約十分之一秒後調整了它的大小。Claude 在調整大小時固定了佈局,我們添加了一個測試來模擬預渲染流程。
這個循環很有成效,但它不是自主的。讓它保持快速、安全並走上正軌是我們的職責,它包含三個部分。
雄心。預設情況下,Claude 對範圍很謹慎。它會記錄發現的問題,對可行性持保留態度,並誇大其估計。但我們對我們的守衛很有信心。我們所做的很多事情,尤其是在早期,都是為了鼓勵 Claude 更大膽。
是的 — 一個小的 PR,讓 Code 擁有與 Chat 和 Cowork 相同的計時標記。我將在本週內提交;實際上 Code 的數字需要幾天時間才能合併、部署和進行基準視窗。
如果你現在就提交,我會將其合併並部署。我們有能力做任何事情。請更勇敢一些。
正在處理 — PR 將在一小時內上線。
當我們開始達到我們設定的目標時,我們注意到討論串的速度變慢了。Sam 在每個討論串中都傳達了同樣的信息:「讓我們繼續推進,目標不是終點。下一步是什麼?要大膽。」
品味。每個討論串都有一個指定的人類負責人,Claude 會用前後對比的螢幕截圖或錄影來突出任何使用者可感知的變更,供他們裁決。表格應該逐格填滿,還是等到每一行都完成?載入骨架應該立即顯示,還是只在半秒後顯示?逐字淡入串流文字是否值得佔用五分之一的幀預算?Claude 尋找節省毫秒的方法,我們權衡了取捨。
方向。我們將每個討論串故意保持狹窄,專注於一個基準測試或流程,並要求 Claude 僅在此範圍內尋找改進。我們將這些討論串視為一百五十把錘子尋找釘子。我們的大部分通話都與排序和使用者影響有關:優先考慮哪些介面,如何合併相互干擾的討論串,以及何時關閉一個已達到邊際效益遞減的討論串。一個 900 行的 PR 得到了一行回覆:「為了維護這個建置插件的複雜性,每發送 2 毫秒的優勢是不值得的。」
我們的一個側邊任務展示了所有內容的協同工作。為了演示對即時語法高亮顯示中使用的正規表達式進行的優化,Claude 附加了一個在實驗室中串流長答案的螢幕錄影。在角落裡,它添加了一個幀率讀數,該讀數是從動畫幀時間戳計算出來的。
這實際上是一個很酷的基準測試。我們是否以 60 fps 為上限?你能嘗試將滾動和串流流暢度推向 120 嗎?如果我理解正確的話,你的設備可能不支持。
好的,今天的設備以 60 Hz 運行,因為無頭 Chromium 預設是這樣。我相信它可以以 120 Hz 運行(無限制的 vsync 或 DevTools 幀控制)— 首先確認這一點,然後我將針對 8.3 毫秒的幀預算重新運行評估。
關於 120 Hz 設備的更新:它有效。透過 DevTools 的 begin-frame 控制,在無頭 Chrome 中可以確定地以 120 Hz 幀步進 — 240 個 begin-frames 精確地 240 幀,每幀 8.33 毫秒,因此「該幀是否符合 120 Hz 預算」變成了一個精確的讀數,而不是一個嘈雜的讀數。
一旦機制和雄心建立起來,Claude 就開始工作了。每個繪製的幀都有 8.33 毫秒的預算,所以 Claude 逐幀檢查長答案,計時每一幀以找出慢的部分。它消除了每個塊的 O(訊息長度) 工作,方法是記憶化已完成的塊,將增長程式碼塊的標記邏輯移到工作程序,並逐單元格顯示表格。
在這個討論串中,我們合併了近六十個 PR。長答案在總共約 200 毫秒內阻塞了主執行緒,而以前是約 750 毫秒,消耗的 CPU 約為三分之一,並且在 120 Hz 的 MacBook 上從頭到尾保持 120 fps。120 Hz 設備本身成為了一項夜間作業,Claude 負責監控回歸。
Claude 在 Web 和桌面上的長答案現在串流的流暢度約為 4 倍。
我們重建了串流渲染器,使其只觸及仍在變化的內容,因此長答案在較慢的筆記型電腦上延遲減少了 9 倍,最長的凍結時間縮短了 4.5 倍,並且在 120Hz 的 MacBook 上從頭到尾保持 120fps。
— ClaudeDevs (@ ClaudeDevs ) 2026 年 8 月 24 日
當我們開始衝刺時,我們並沒有計劃對串流期間的毫秒級幀時間進行爬坡。但結果證明我們可以計算它們 — 任何我們可以計算的東西,Claude 都可以進行爬坡。
今天,claude.ai 和桌面應用程式的速度比八月初快了約 3 倍,並且計數器應該能讓它們保持這個速度。但我們還沒有完成:第 95 百分位數、其他流程以及非常長的對話仍然有改進空間。在另一篇文章中,我們還將介紹衝刺期間我們進行的一些上游側邊任務,其貢獻已進入 Electron、Chromium、Node.js 等領域。
當我們在內部分享結果時,Issac 說得最好:「即使在六個月前,你也不會相信這是可能的。」我們預計將繼續這樣工作,一次一個討論串,以任何規模進行。頻道仍在運行。
由 Alfred Xing、Anthony Morris、Benjamin Pasero、Chase McCoy、Joshua N.、Luke Taylor、Marius Schulz 和 Shelley Vohr 貢獻。特別感謝 Boris Cherny 鼓勵我們更加雄心勃勃。