這帶來了重大的技術挑戰,因為我們致力於將延遲降至最低。為了每秒處理數十萬甚至數十萬個邊緣函數請求,我們需要處理每個請求、正確路由、分配計算容量,並啟動我們的平台程式碼和客戶的程式碼。所有這些都必須在幾毫秒內完成。
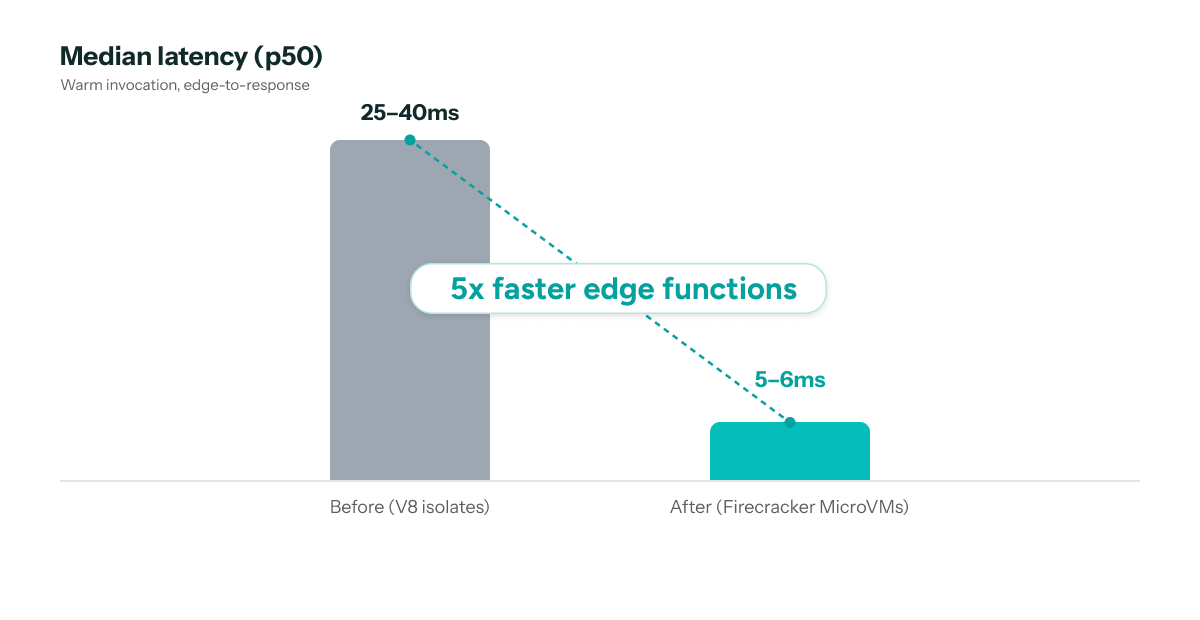
在過去幾個月裡,我們的團隊與 Unikraft 團隊密切合作,重建了邊緣函數的基礎設施。過去,請求會發送到一個託管的執行服務。如今,它們在我們自己的邊緣網路內的 MicroVMs 上運行——中位數速度約快 5 倍。這一轉變也提高了安全性與可靠性,並為在邊緣運行複雜計算開闢了更多可能性。
這不會改變邊緣函數的編寫或使用方式——URL 導入、npm 套件、Node 內建功能、netlify.toml 聲明、本地開發——所有這些都與以前完全相同。現在它更快、更具彈性。在本文中,我們想分享更多關於新架構以及我們在建構能夠以低效能開銷服務高流量的新計算平台方面的經驗。
邊緣函數運行在網站前面,處理每個符合條件的請求。它所花費的時間就是客戶等待的時間,因此這裡的毫秒數比幾乎任何其他地方都更重要。
A warm invocation — routing to a compute node, entering a MicroVM, running the function, producing response headers — now costs:
一個溫暖的調用——路由到計算節點、進入 MicroVM、運行函數、產生響應標頭——現在的成本是:
一個冷調用也值得說明。當請求到達一個計算節點尚未見過的區域時,它需要先獲取相關映像檔才能運行任何東西。這發生在大約 1.2% 的調用中,平均耗時約 9 毫秒。
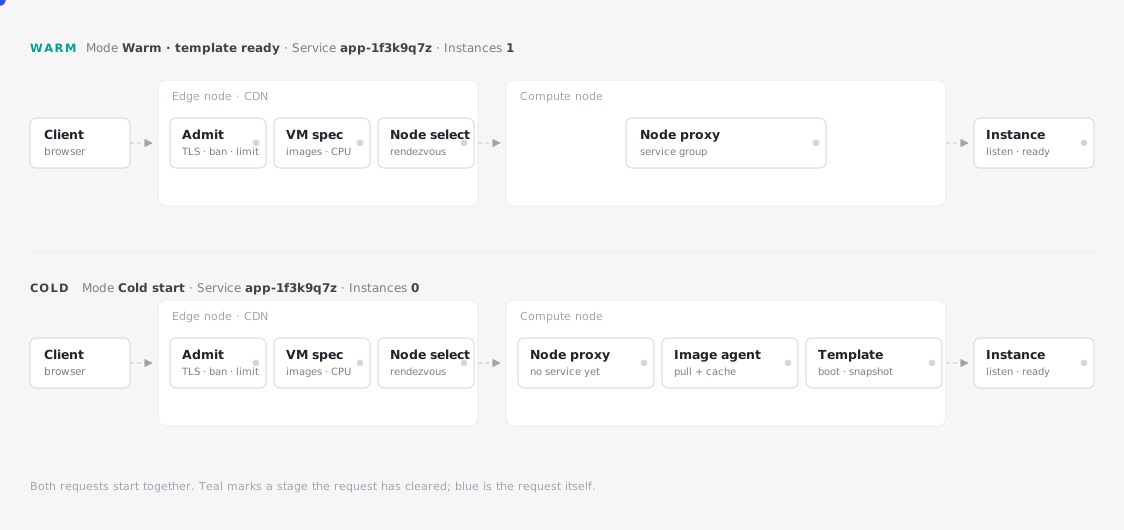
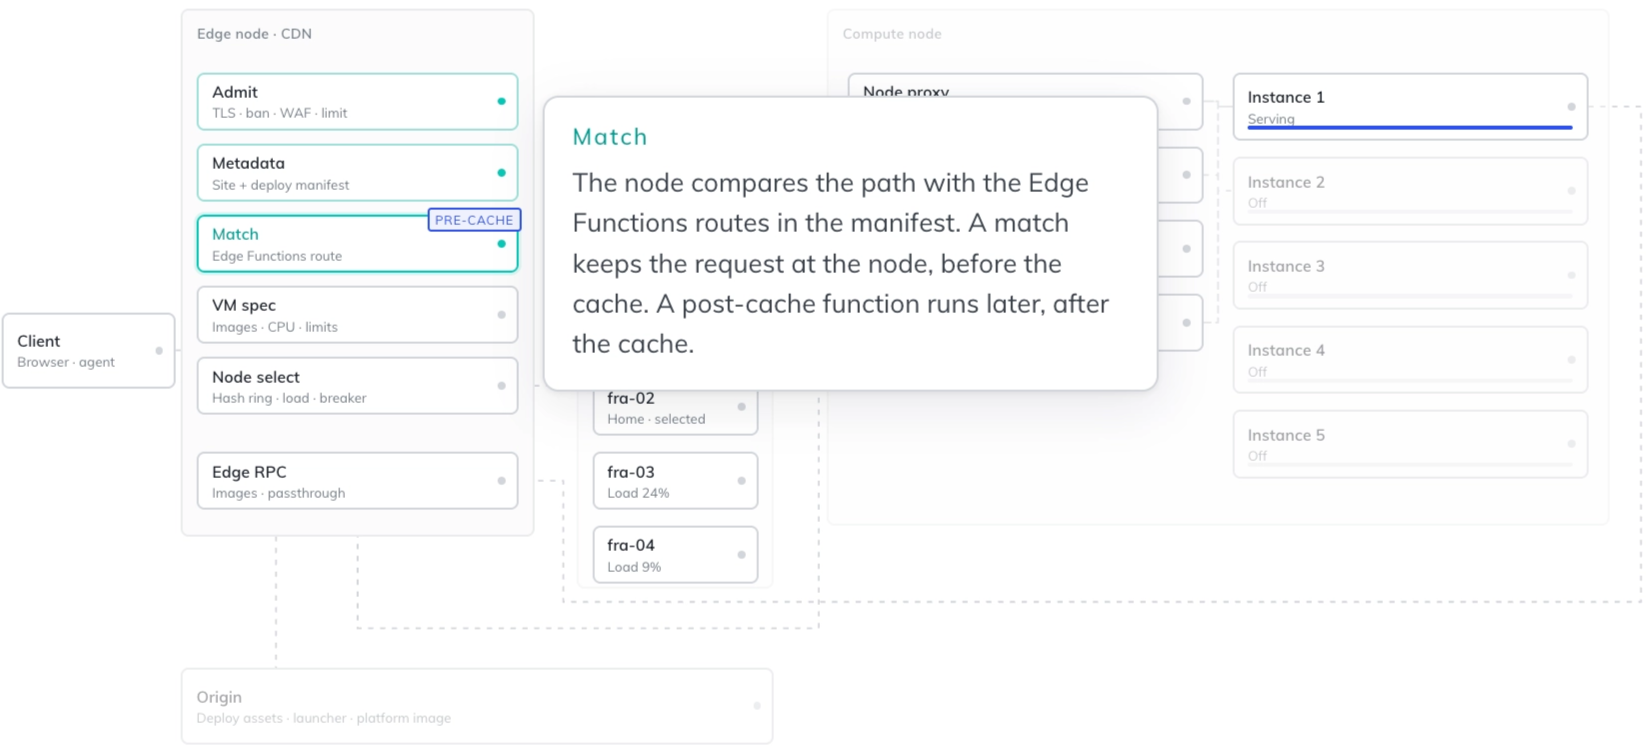
以下是單個請求的處理路徑,依序為:它到達邊緣節點,被轉換為規格,路由到計算節點,然後交給一個可能已存在也可能不存在的 MicroVM,這取決於它是冷調用還是溫暖調用。
每個請求都會到達離客戶端最近的 Netlify 邊緣節點。該節點終止 TLS 連接,並將請求路徑與該部署的邊緣函數路由進行比較。
如果沒有匹配項,請求將像往常一樣繼續傳輸到快取並到達源站。如果路由匹配,這就是請求以前離開我們網路的點。使用我們舊的基礎設施,它會通過網際網路傳輸,運行邊緣函數,然後返回給我們進行傳遞。使用新的計算平台,請求會被轉發到我們網路內的計算節點。
當計算節點收到帶有機器規格和服務 ID 的請求時,它首先檢查具有該 ID 的服務是否已存在。如果存在,它會將請求轉發到服務,以便將其發送到 MicroVM。服務允許我們將多個 MicroVM 與同一網站的邊緣函數關聯起來,並允許我們配置參數來決定何時擴展 MicroVM 的進出。例如,我們配置每個服務僅允許 MicroVM 處理固定數量的請求,然後將其關閉,以避免 MicroVM 無限期運行。我們使用相同的參數來知道何時預先啟動另一個 MicroVM,以預期一個將要關閉的。
如果計算節點上不存在該網站邊緣函數的服務,則會創建一個,然後我們檢查磁碟上是否具有機器規格所需的所有映像檔。如果缺少任何映像檔,則會從邊緣節點獲取並寫入磁碟。這種方法意味著我們只獲取該區域內正在接收流量的邊緣函數映像檔。
在請求發送任何地方之前,邊緣節點會編寫將運行函數的機器的規格。該規格命名了三個映像檔:運行時、我們的平台映像檔和邊緣函數映像檔。它還設定了 CPU、記憶體和連接限制。
該規格隨請求一起傳輸,每次請求都如此。計算其雜湊值和特定於網站的信息,以成為服務 ID。這允許隔離,因為具有不同程式碼或不同環境變量的兩個部署是不同的服務,它們永遠不會共享 MicroVM。
這種隔離對於我們不希望發生的故障最為重要。一個潛在受損的部署運行在一個單獨的 MicroVM 中,即使它逃脫了運行時,它也不能毒害其他客戶端或計算層本身。V8 isolates,無論其名稱如何,都無法提供這種程度的隔離。
每個區域都有一個計算節點組。邊緣節點使用 rendezvous hashing 選擇一個用於服務:同一個服務每次都會落在同一個節點上,這就是保持 MicroVM 溫暖以及程式碼已在磁碟和快取中的原因,一旦它被讀取。這種粘性為我們提供了快取策略。如果我們將請求均勻地分散到整個群組中,我們將面臨更高水平的冷啟動。
重要的是要記住,雖然將函數的每個請求發送到同一個計算節點是快速路徑,但這也是熱點形成的方式——一個繁忙的函數與該機器上的所有其他東西競爭資源。一個佔據區域流量很大一部分的服務被固定在單個節點上,將會飽和該節點,而損害其他服務。
我們通過放鬆粘性來平衡這一點。超過一定閾值後,我們將服務分散到一部分節點。這使我們能夠吸收單個客戶端流量的突然激增,而不會影響已哈希到同一節點的其他服務。
最後,一旦選擇了節點,它就會載入函數的程式碼。先前服務過該函數的計算節點已經擁有它。第一次看到它的節點會獲取一次並將其快取,因此只有第一個請求需要支付此成本。
每個函數都在自己的 Firecracker MicroVM 中運行。這些 MicroVM 在不到一毫秒的時間內創建,並在 p99 下約 2 毫秒內啟動,因為 VM 啟動的是一個簡化的 Linux 環境而不是完整的作業系統。邊緣函數的文件被掛載為未壓縮的 EROFS 映像檔,然後進行記憶體映射,因此 VM 只讀取它實際使用的捆綁包部分,而不是載入全部。
當 MicroVM 啟動並且 JavaScript 伺服器開始監聽一個端口時,我們就會拍攝 MicroVM 的快照。當邊緣函數未被調用時,運行它的 MicroVM 會縮減到零而不是閒置。下次調用時,我們從該快照啟動一個新的 MicroVM。快照是記憶體映射的,因此 VM 可以在等待整個快照被讀回記憶體之前開始執行。
VM 的生命週期——啟動、快照、恢復和縮減到零——是 Unikraft 產品的工作。我們在遷移過程中與他們密切合作,以確保它能夠承受我們的請求量和流量模式。
在運營此項目多年後,我們已經有了可以最大化效能和調試能力的經驗。
在規模化運營中,我們遇到了各種各樣的問題,從虛擬交換機上的端口耗盡到 DNS(我們很驚訝,但並非總是 DNS)。
在此次迭代中,我們確保計算節點運行本地 DNS 解析器。我們還擴展了收集的指標,記錄了啟動時間、第一個端口打開的時間以及用戶程式碼啟動的時間。還有幾個斷路器到位,以確保及時重新路由和退役計算節點。
這就是整個路徑,在溫暖的實例上大約增加 6 毫秒。沒有任何東西離開我們的網路,我們完全控制整個請求週期。以上所有操作都發生在請求到達和響應發出之間。
當你構建上述系統時,你同時優化兩件事:最終用戶體驗和推出彈性。我們需要能夠快速推出變更,但也要能夠同樣快速地回滾。
計算節點是從 Unikraft 發布的基本映像檔構建的,並安裝了一組套件。這些節點與我們的邊緣節點分開構建有幾個原因:它使我們的邊緣節點輕巧快速,它允許我們為計算節點使用不同的實例類型,並且它允許我們獨立擴展這些節點。
一個控制平面負責跟踪哪些計算節點存在以及哪些是健康的,邊緣節點會輪詢它以獲取該列表。它也是驅動部署的組件——一個新的機群與正在運行的機群一起啟動,擴展以匹配它,並且只有在健康時才會接管流量。
構建計算基礎設施需要與 Unikraft 團隊的緊密合作。在整個遷移過程中,我們與他們合作進行正確性測試、處理大量請求以及構建特定於我們平台的架構。
重建我們邊緣計算基礎設施的工作不僅僅是速度提升。它是一個我們可以繼續建立並擁有更多控制權的更快基礎。最好的部分是,它已經以相同的定價為您的生產流量提供服務,無需遷移步驟,也無需更改任何項目。
自己運行計算意味著邊緣函數的上限由我們來提高。這使得三件事變得可行,而以前則不然:
我們在這裡還沒有結束。我們以前無法觸及的限制和粗糙邊緣是我們現在正在努力解決的問題,敬請關注。