我寫這篇文章,是希望你們不要像我差點做的那樣,在額頭上拍一下,當時我決定在生產環境中啟用 Swap 來吸收記憶體尖峰。
我有一個包含兩個處理序的 cgroup:一個是 Go 處理序,它會呼叫 io.ReadAll 然後 proto.Unmarshal,建立一個 blob,接著是一個圖結構(在 Go 的分配器中被標記為可掃描)。另一個處理序是一個 HTTP 伺服器,它大部分時間都很安靜。
當收集器執行時,它會逐個指標地讀取這些掃描範圍,並決定如何處理它們。所以我想:好吧,在記憶體壓力下,核心將會把頁面逐出到 Swap 裝置,但由於逐出是按 cgroup 而非按處理序進行的,所以兩個處理序的頁面都會被逐出——因此只有很小的機會會變成核心與垃圾收集器之間進行 Swap 進出(swap-in and swap-out)的悲傷之舞。
我錯了。在實驗過程中,我發現了一個可能傷害到我的問題:Go 的垃圾收集器在「停止世界」(stop-the-world)暫停期間讀取其元數據(位於堆積之外,一個不會被釋放的區域),而這些元數據可能在 Swap 中。
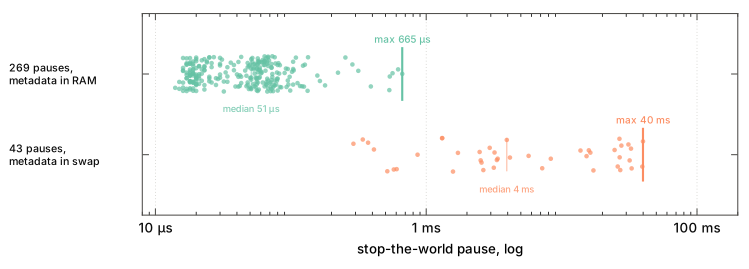
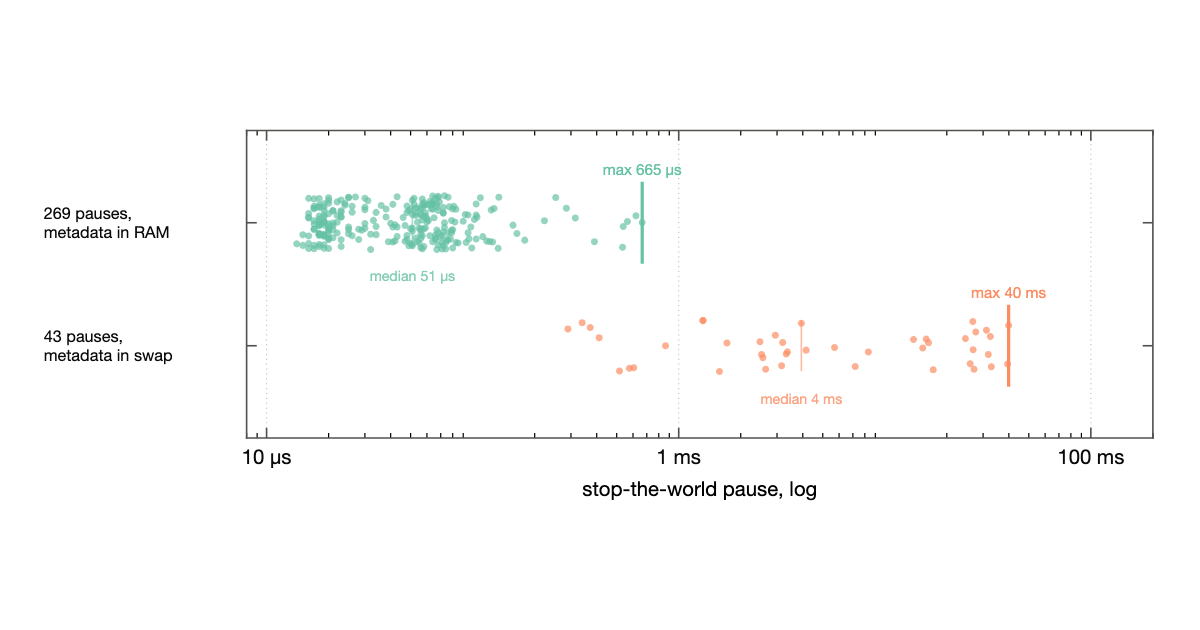
我在 Hetzner 的機器上使用核心 6.8 並啟用 MGLRU 進行了模擬運行。你可以在這裡找到關於這些實驗的所有內容:圖表、模擬分配器、bpf 腳本、python 腳本等:https://github.com/frnsimoes/go-gc-swap-cost。中位數暫停時間約為 51 us。當元數據位於 NVMe 上時,最長的暫停時間為 40ms。
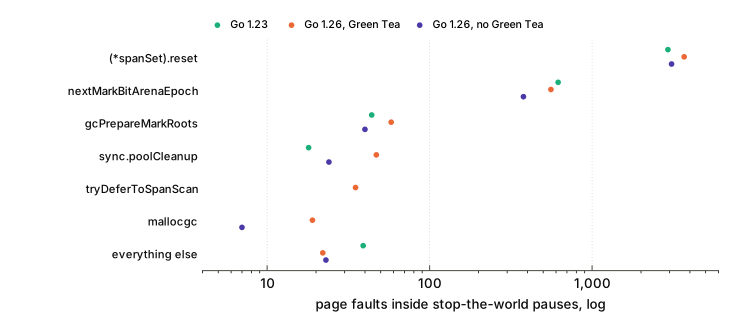
為了檢查這 40ms 的去向,我寫了一個小的 bpf 腳本來計算在世界停止期間發生的頁面錯誤數。這是最長的一次:39902 us,期間的錯誤數為 228,錯誤佔用了 39013 us。這 40ms 中的 39ms 花費在了 228 個頁面錯誤上。這些錯誤發生在 GC 的簿記過程中:
這是一個潛在的故障模式。Go 的 GC 在兩個點必須停止世界:當它執行掃描終止(sweep termination)時,以及當它執行標記終止(mark termination)時。在 30 分鐘內,我們遇到了 312 次這樣的暫停。
所以這就是為什麼會發生這種情況:運行時分配了這些頁面。它們不會被釋放,而是被重複使用。這些頁面在 GC 週期中被讀取。由於核心是按年齡逐出頁面,它會將最近最少存取的頁面發送到 Swap。GC 執行,停止世界,嘗試讀取這些頁面,但現在我們遇到了主要的頁面錯誤。核心需要讀取 PTEs,然後呼叫 do_swap_page,尋找一個新的框架,將其計入 cgroup,讀取頁面,提交一個 bio,等待磁碟,然後將它們放回記憶體——簡而言之就是這樣。
這 40ms 初看起來似乎無害。但我們談論的是一次「停止世界」的暫停。這 40ms 意味著一切都停止了——用 Go 的術語來說,每個 P 都停止了,所以,例如,如果一個 goroutine 正在等待 I/O,在這段暫停期間,I/O 可能會返回,但沒有人來處理它。40ms 是中位數暫停時間的 800 倍。在測試期間,每次記憶體尖峰會發生兩到三次。這非常多。
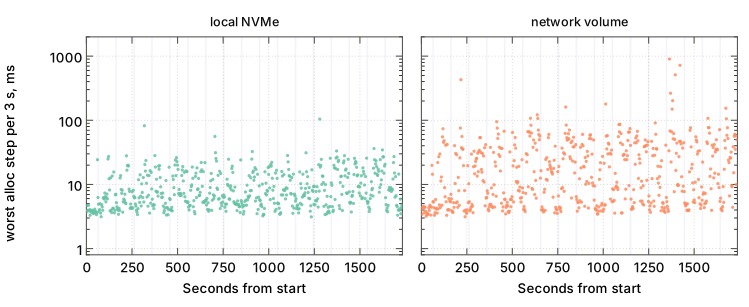
然後我注意到另一件事:建立一個 511 KiB 的訊息,通常需要 3-5 ms,在 NVMe 上跳升到 105 ms,在 Hetzner 的網路磁碟區上則高達 903 ms。每條訊息,這個成本都超過了元數據暫停的成本。但只有進行分配的 goroutine 支付了這個價格,所以至少它是局部化的,而不是像元數據那樣是全局的。
我還沒有確認時間花在哪裡,但即便如此,我也想在這裡提到它,因為這是你必須付出的另一項成本。無論如何,我同意 Chris Down 的觀點,Swap 並非全然邪惡。但是,是的,它與垃圾回收的表現不佳,而且在生產環境中,我正在收集很多東西。
有人問我 Go 1.26 的 Green Tea 垃圾收集器是否改變了 GC 讀取元數據的方式。我測量了一下,影響微乎其微。
你可以在這裡找到關於這些實驗的所有內容:圖表、模擬分配器、bpf 腳本、python 腳本等:https://github.com/frnsimoes/go-gc-swap-cost