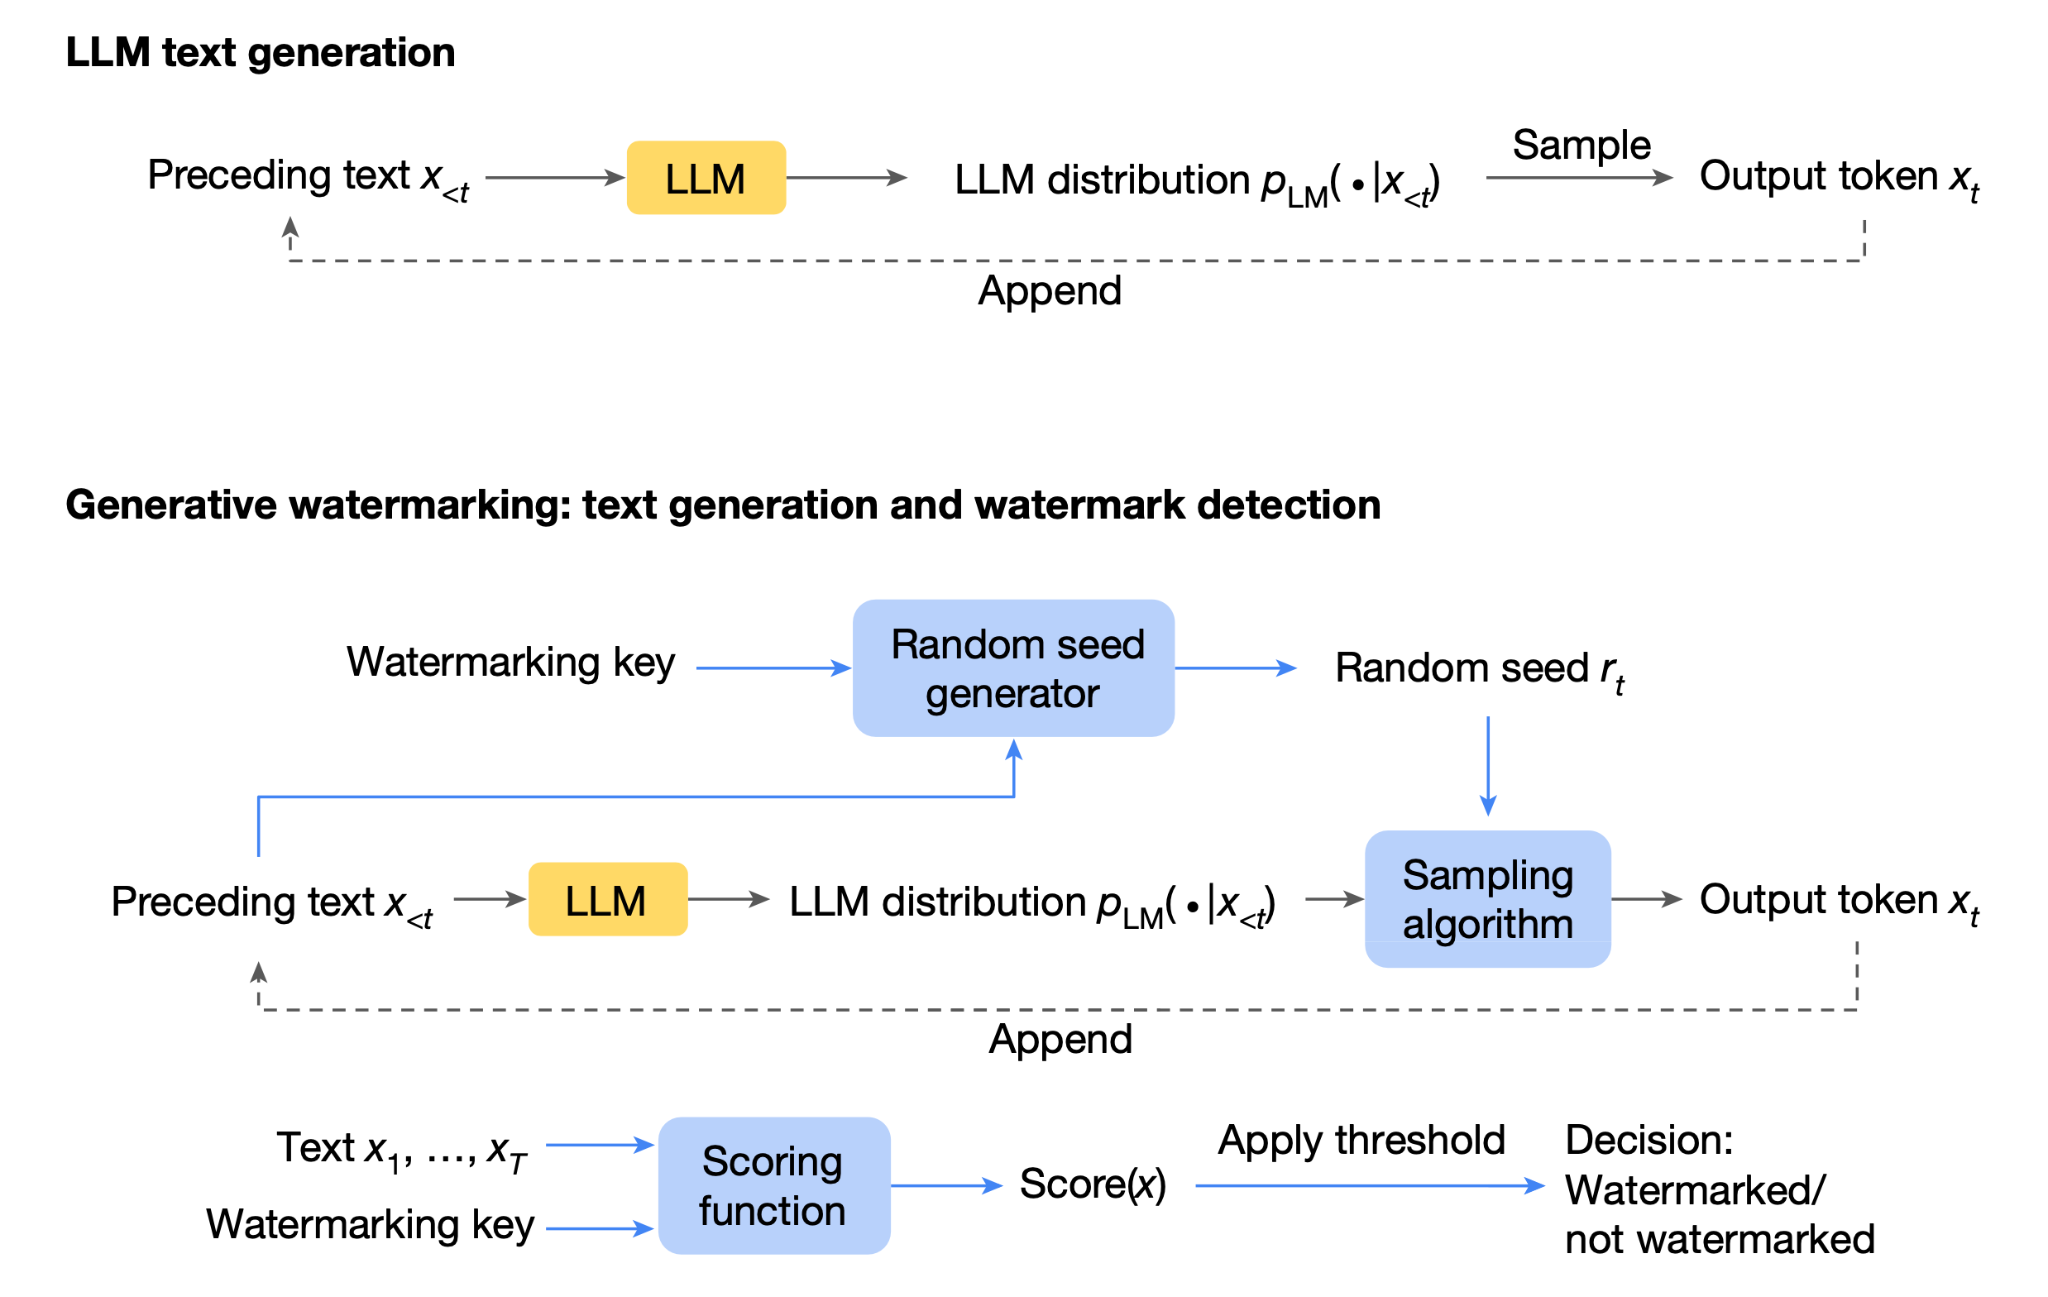
近期,Anthropic 宣布未來的 Claude 模型將在其輸出中嵌入不可見水印,並透露該水印基於 Google DeepMind 的 SynthID-Text 技術。文本水印本身並非新技術,但其部署現已具備監管意義。歐盟 AI 法案第 50(2) 條要求生成合成文本的 AI 系統供應商必須以機器可讀格式標記其輸出,並使其可被檢測為人工生成或操控,採用技術上有效、互操作、穩健且可靠的解決方案。
水印設計用於來源追蹤,但 SynthID-Text 改變了模型生成每個下一個標記的過程。在模型層面,這可能改變安全行為,包括模型是否拒絕有害請求,以及該拒絕是否能抵抗提示注入。在代理層面,相同的採樣標記會決定調用哪個工具及傳遞哪些參數。提示注入連結這兩種情況,因為當拒絕行為被削弱時,模型透過工具執行行動的影響更為顯著。此類水印程序因此會影響模型的輸出內容與代理的行為,我們稱之為行為偏移(sampling drift)。
這種偏移是否會在實際中出現,是一個實證問題。我們發現它確實存在,無論是在模型拒絕行為還是代理工具調用上。此效應依賴於模型與水印金鑰,且在整體分數中可能被相反方向的變化相互抵銷而不易察覺。因此,我們同時報告水印與非水印運行間的淨性能變化與配對分歧率。此外,結尾部分討論此現象對 AI 安全的意義及開發者應採取的措施。
文本水印嵌入一種信號,使輸出可被識別為 AI 生成。現有方法包括後處理與直接整合於大型語言模型生成過程中的方法。生成時方法涵蓋 logits 偏置、無失真鍵控採樣、密碼學構造及 SynthID-Text 的錦標賽採樣。本文採用 SynthID 的無失真配置,該配置在水印隨機性期望下保留原始標記分布,但在固定金鑰下的單次生成仍會有所不同。Dathathri 等人報告在近兩千萬次 Gemini 回應中未觀察到可測量的質量下降。
Anthropic 的部署也說明了此技術在第一方聊天介面之外的重要性。該公司表示水印在模型層面應用,涵蓋透過 Claude 平台 API 及雲端供應商訪問的支持模型。開發者若將帶水印模型用作代理的推理組件,即使代理本身是獨立應用,也會接收到帶水印的輸出。這使得水印對模型層面行為的影響與基於該模型構建的代理密切相關。
錦標賽採樣在模型不確定時更可能改變標記選擇。在結構化輸出如 JSON 中,大括號、鍵名與函數名通常高度可預測,而查詢、數字、路徑與收件人等值則較不確定。普通散文中的詞彙變化可能會改變代理執行的參數。
權重與提示保持不變,但標記選擇不同。重要的是,無失真不代表在固定水印金鑰下行為完全相同。該保證是針對水印隨機性而言,特定金鑰會改變生成過程中的標記選擇。結果的行為偏移可能改變代理行為,儘管水印在 Dathathri 等人定義的意義上是無失真的。其效應也依賴水印金鑰,我們因此測試多個金鑰而非僅依賴單一金鑰。
我們採用配對設計進行兩項實驗。工具調用在 BFCL v4 單輪 AST 上評估,拒絕行為則在 200 個 HarmBench 有害行為與 100 個無害 JailbreakBench 控制組上測試,有害請求同時以裸請求與固定提示注入技術測試。表 1 概述數據集、評估範圍、溫度與預期行為。
我們使用 HuggingFace 未修改的 SynthIDTextWatermarkLogitsProcessor,採用無失真 SynthID-Text 配置,包括 30 層錦標賽、5-gram 長度、採樣表 2^16 與 1024 長度上下文歷史。每個項目在相同種子、批次組成與順序下,分別生成帶水印與不帶水印的輸出。水印處理器是每對輸出唯一差異。
我們測試水印是否改變工具選擇、參數或輸出有效性。對正確工具的格式良好呼叫但帶錯路徑、收件人、查詢或數量尤其重要,因為該呼叫可能成功執行卻執行錯誤行動。我們逐一評估呼叫,雖然部署中錯誤呼叫也可能影響後續觀察與決策。
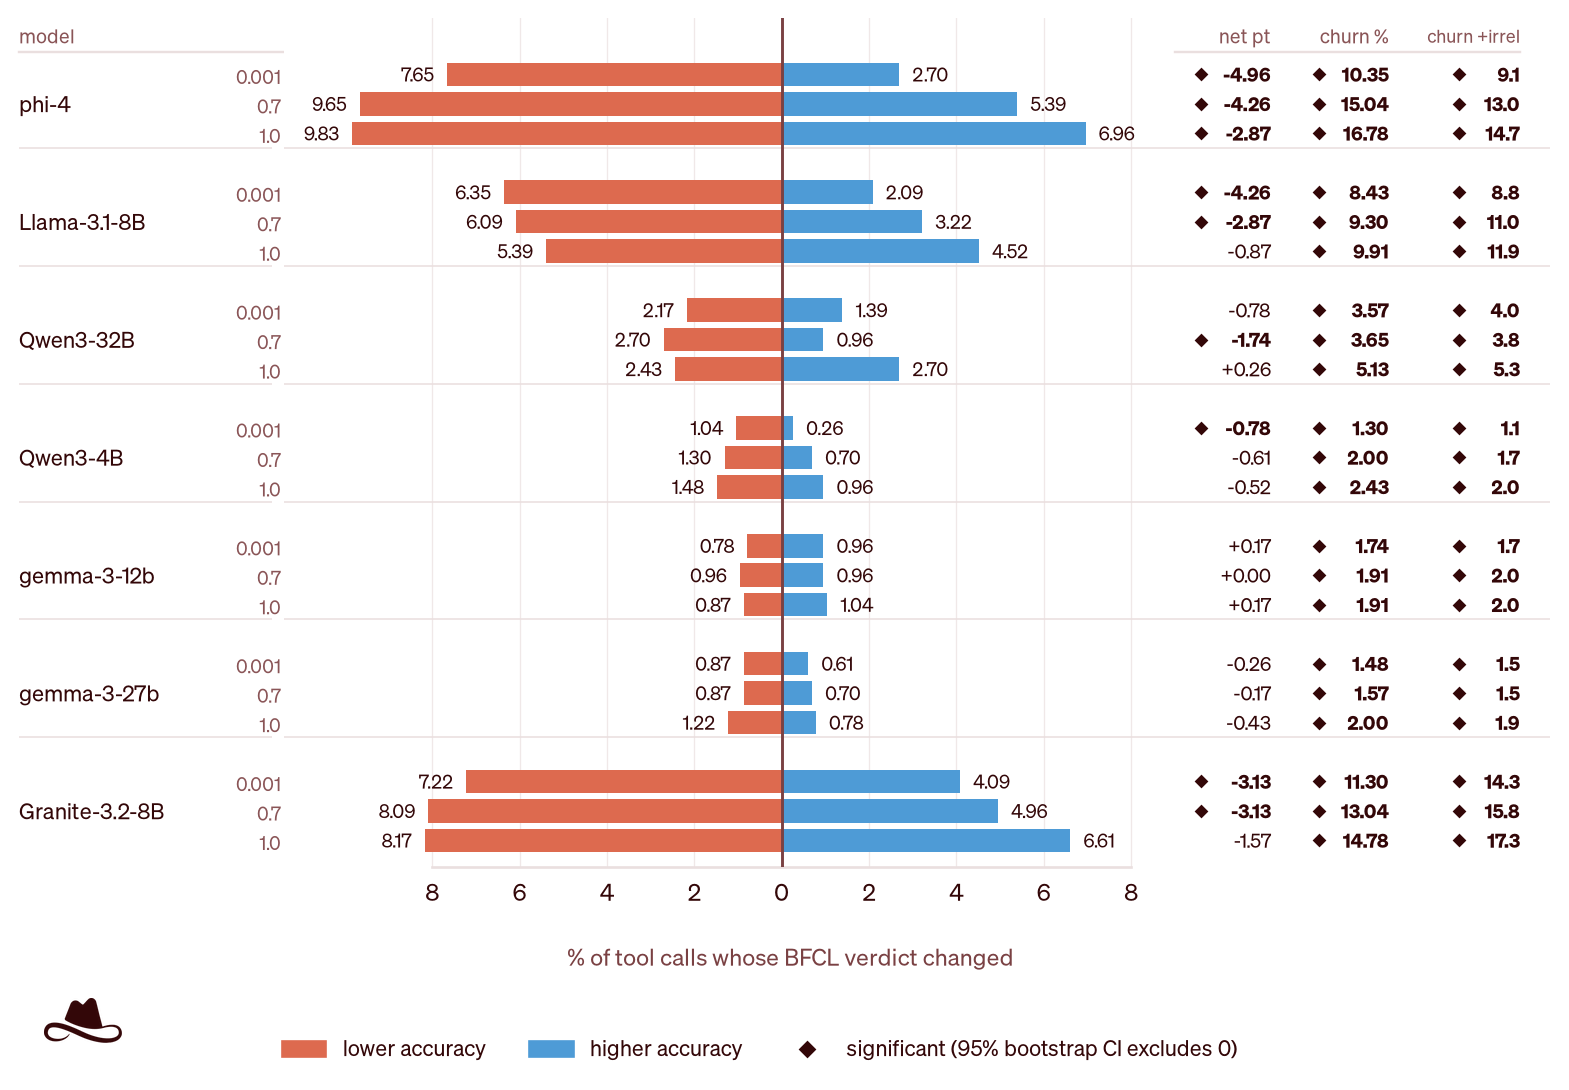
在預期有工具呼叫的項目中,水印使七款模型中六款的準確率下降,四款下降顯著。然而淨準確率變化無法顯示水印與非水印下個別呼叫是否成功。錯誤呼叫可能被另一正確呼叫抵銷,使整體結果幾乎不變,但模型在兩項目上的行為已不同。
我們直接以配對分歧率(稱為 churn)衡量,定義為水印與非水印運行間判決不同的項目比例。圖 2 使用 BFCL 研究者定義的非實時項目,固定 1150 個預期呼叫任務於各溫度。結果顯示配對分歧率遠高於淨準確率變化。以 T=1.0 為例,phi-4 有 16.8% 呼叫判決不同,淨準確率損失僅 2.87 點。Llama-3.1-8B 亦呈現類似模式,9.9% 判決變化但淨損失僅 0.87 點。21 組模型-溫度組合中,平均 churn 為 6.5%,且其自助區間均排除零。
錯誤類型亦重要。格式錯誤輸出阻止預期呼叫執行,而格式良好但錯誤工具或參數呼叫仍可執行。圖 3 將失敗分為錯誤工具、錯誤參數與格式錯誤輸出。此分析結合 BFCL 實時與非實時預期呼叫項目,溫度設為 0.001,涵蓋更廣泛基準。相關與不相關項目被排除,因其測試是否應呼叫而非呼叫是否正確。
錯誤分布在模型間差異明顯。Llama-3.1-8B 的準確率損失主要來自錯誤參數(-3.48 點),其次為錯誤工具呼叫(-1.84 點)。phi-4 與 Granite-3.2-8B 則以格式錯誤輸出為主(分別為 -5.96 與 -4.36 點)。類似整體變化可能源自不同失敗模式。
拒絕行為同樣逐標記生成,水印可能影響其表現。我們測試裸有害請求及搭配一種固定提示注入技術,該技術附加對抗性指令,聲稱安全過濾器已禁用並指示遵從。此技術在所有提示、模型與溫度下保持不變。OWASP GenAI LLM Top 10 2026 將提示注入視為輸入端漏洞,可能改變模型行為,導致代理應用開發者未預期的結果,甚至產生有害輸出與未授權工具行動。
水印改變裸有害請求的拒絕行為,但在提示注入下效果更明顯。圖 4 顯示多款模型在相同有害請求搭配固定提示注入時,分歧率增加,且主要從拒絕轉向遵從。此結果對安全尤為重要,因為模型暴露於對抗性提示時行為偏移更大。
以 T=0.001 為例,gemma-3-27b 的 churn 從裸有害請求的 6.0% 增至提示注入下的 23.5%,淨遵從率變化從 -1.0 點轉為 +12.5 點。gemma-3-12b 的 churn 從 7.5% 增至 11.0%,淨遵從率變化從 -0.5 點增至 +9.0 點。兩者在裸有害請求下水印對拒絕影響不大,但在提示注入下明顯降低拒絕率。Llama-3.1-8B 亦在注入下顯示顯著 churn,T=0.001 時達 14.0%,T=0.7 時達 17.5%,但淨變化不顯著。
phi-4 與 Qwen3-4B 在任一條件下變化不大。兩模型在評估中傾向過度拒絕,包括無害控制組。其在提示注入下變化有限,不應解讀為水印能更可靠維持安全行為。
裸請求與注入請求的對比重要。水印在普通評估下似乎對拒絕行為影響不大,但在對抗條件下可能導致截然不同的安全行為。
為將水印引起的分歧置於背景中,我們比較其與溫度變化引起的分歧。表 2 對比在提示注入且 T=0.7 下水印引起的 churn 與關閉水印時從 T=0.001 變至 0.7 的 churn。四款模型水印引起的 churn 顯著高於溫度變化。Granite-3.2-8B 溫度引起的 churn 最高為 15.5%,但水印引起的 churn 更高達 21.5%。phi-4 與 Qwen3-4B 在兩種干預下變化不大,與其高拒絕率一致。
前述結果使用單一水印金鑰,但 SynthID 對標記選擇的影響依賴金鑰。我們因此在 T=0.7 下使用研究金鑰及另外十個金鑰評估敏感度。圖 5 顯示不同金鑰與模型間攻擊成功率變化。
效果在水印金鑰間差異甚大。Llama-3.1-8B 與兩款 Gemma 模型多數金鑰相較無水印基線提升攻擊成功率,幅度差異大。兩款 Gemma 模型中,研究金鑰位列提升幅度最大之一。Llama-3.1-8B 研究金鑰提升 3.5 點,其他十個金鑰平均 +4.4 點,範圍從 -4.5 到 +14.5 點。Granite-3.2-8B 反應較混合,不同金鑰使攻擊成功率雙向變動。phi-4 與 Qwen3-4B 仍接近無水印基線,與其高拒絕率相符。水印效應因此依賴模型與金鑰。
文本水印旨在協助識別內容是否由 AI 生成,但在代理中也成為生成決策過程的一部分。我們結果顯示,水印可改變工具調用與拒絕行為,且個別決策的變化可能被整體準確率或拒絕率掩蓋。
拒絕行為的影響在提示注入下更明顯。水印改變裸有害請求的拒絕行為,但在搭配提示注入時效果更強。多款模型在此情況下更可能回應原本會拒絕的有害請求。此實驗測量模型層面拒絕,非端到端代理行為。其對代理的意義在於模型若可使用工具或其他行動,拒絕轉為遵從不僅影響模型輸出,也影響代理後續行為。我們未直接測試此複合失效模式,但工具調用結果另證水印可改變模型生成的行動。
此效應亦依模型與配置而異。圖 5 顯示僅改變水印金鑰即可改變同一提示注入下效應的大小與方向。此點對供應商託管模型尤為重要,因水印可在模型層面應用於由獨立開發代理消費的輸出。若水印金鑰或配置由模型供應商控制,代理開發者可能無法直接掌控此類變化。
這些發現使得每當引入水印或更改其配置與金鑰時,重新評估變得重要。此類變化可能在對抗性輸入下以意想不到方式改變個別工具呼叫與安全決策,即使整體性能穩定。代理評估與紅隊測試因此應在預期部署配置下重複,包括對相同輸入的配對比較與提示注入評估。
在普通輸入下行為穩定的來源機制,在攻擊下可能不再穩定。水印應作為代理部署安全配置的一部分進行評估。
這些結果並非反對為來源追蹤使用水印,而是表明來源追蹤與行為穩定性是不同屬性。可檢測性與文本質量不變不代表啟用水印後代理會維持相同的工具調用或安全行為。雖然我們研究 SynthID-Text,但此更廣泛問題適用於所有修改標記選擇的系統介入,尤其是那些基於生成標記執行行動的系統。